Spring AI介绍与基础使用
约 7059 个字 488 行代码 1 张图片 预计阅读时间 30 分钟
Spring AI介绍
2025年5月20日,Spring AI官方宣布1.0 GA(General Availability)版本正式发布,这是Spring官方推出的首个稳定版人工智能集成框架.旨在帮助Java/Spring开发者更便捷地在企业级应用中集成AI能力(如大语言模型、机器学习、向量数据库、图像生成等)。它的发布标志着Spring生态正式进入AI时代,为Java开发者提供了标准化的AI开发工具链,AI技术正式进入Spring生态的核心工具链
官方文档地址:Spring AI
Spring AI是一个AI工程领域的应用框架,它的目标是将Spring生态系统的设计原则(如可移植性和模块化设计)应用于AI领域,并促进使用POJO作为AI领域应用程序的构建块
Spring AI提供以下功能:
- 支持主要的AI模型提供商,如Anthropic、OpenAI、Microsoft、Amazon、Google和Ollama,支持的模型种类也非常多,如:聊天模型、嵌入模型、图像模型、音频模型、内容审核等
- 跨AI提供商的可移植API支持。支持聊天(Chat)、文本到图像(text-to-image)和嵌入(Embedding)模型的统一接口,同时提供同步和流式API选项。支持访问模型特定功能
术语介绍
模型
模型旨在处理和生成信息的算法,通常模仿人类的认知功能。通过从大型数据集中学习模式和洞察,这些模型可以进行预测、生成文本、图像或其他输出,从而增强各个行业的各种应用。如ChatGPT、DeepSeek、通义千问等等。每种模型能力不同,适合的任务也不同
可以简单理解为模型是一个"超级加工器",这个加工器是经过特殊训练的,训练师给它看了海量的例子(数据),并告诉它该怎么做。通过看这些例子,它自己摸索出了一套规则,学会了完成某个"特定任务"。模型就是一套学到的"规则"或者"模式",它能根据你给的东西,产生你想要的东西
- 输入:我们给的东西
- 输出:模型产出的结果
LLM
LLM(Large Language Model),大语言模型,也称大型语言模型,是人工智能模型中专门处理文本的一种类型,属于语言模型的范畴。LLM的特点是规模庞大,包含数千亿的参数,在海量的文本数据上进行训练,学习语言数据中的复杂模式,旨在理解和生成人类语言。可以执行广泛的任务,包括文本总结、翻译、情感分析等
提示词
提示词是用户或系统提供给大语言模型(LLM)的指令或文本,用于引导模型生成特定输出。可以理解为模型的输入,无论是一个单词、一个问题、一段描述,还是结构化指令,都可视为提示词
提示词最初是为引导大语言模型(如GPT、Claude等)设计的,但其核心逻辑(通过结构化输入控制输出)可泛化到许多其他场景。如多模态系统的混合输入,当大模型处理图像、音频时,自然语言提示词需与其他模态数据协同输入,输入设计草图+文字,提示词为:"生成HTML前端代码"
从工程视角来看,提示词分为用户提示词和系统提示词:
| 类型 | 定义 | 核心功能 | 角色 |
|---|---|---|---|
| 用户提示词 | 由终端用户直接输入,触发单次任务 | 传达即时需求(如提问、创作指令) | 驱动单次任务执行(如生成报告、翻译文本) |
| 系统提示词 | 由开发者预设,嵌入系统后端 | 定义模型身份、行为规范、知识边界 | 持续影响所有交互(如角色设定、安全过滤) |
例如在客服场景中:
- 系统提示词设定"用友好语气解答用户问题"
- 用户输入"订单查询"触发具体服务
词元(Token)
词元是大语言模型(LLM)处理文本时的最小语义单位。用于将文本拆解为模型可理解的离散单元。如同乐高积木是搭建模型的基础,Tokens是语言模型处理信息的“原子”
词元通过分词器将文本拆分而来,不同模型的分词规则不同,同一个词在不同模型中可能被拆分成不同词元
模型的上下文窗口(如128K)实际是词元数量限制,API收费通常按词元数计费(词元=金钱),词元数越多,计算耗时和内存占用越大。所以在使用时,应尽量避免冗余词(如请、谢谢)
第一个Spring AI应用
本次使用的SpringBoot的版本如下:
| XML | |
|---|---|
1 2 3 4 5 6 | |
Note
需要注意,Spring AI要求的SpringBoot最低版本为3.2.x,JDK最低为JDK 17
以Deepseek的API为例,因为DeepSeek的API做了针对OpenAI的兼容,所以可以直接使用OpenAI的依赖,下面的pom配置是亲测可用的配置(不考虑流式输出):
| XML | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | |
根据官方文档的介绍进行如下的配置:
| YAML | |
|---|---|
1 2 3 4 5 6 7 8 9 | |
编写测试代码:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 | |
结果如下图所示:
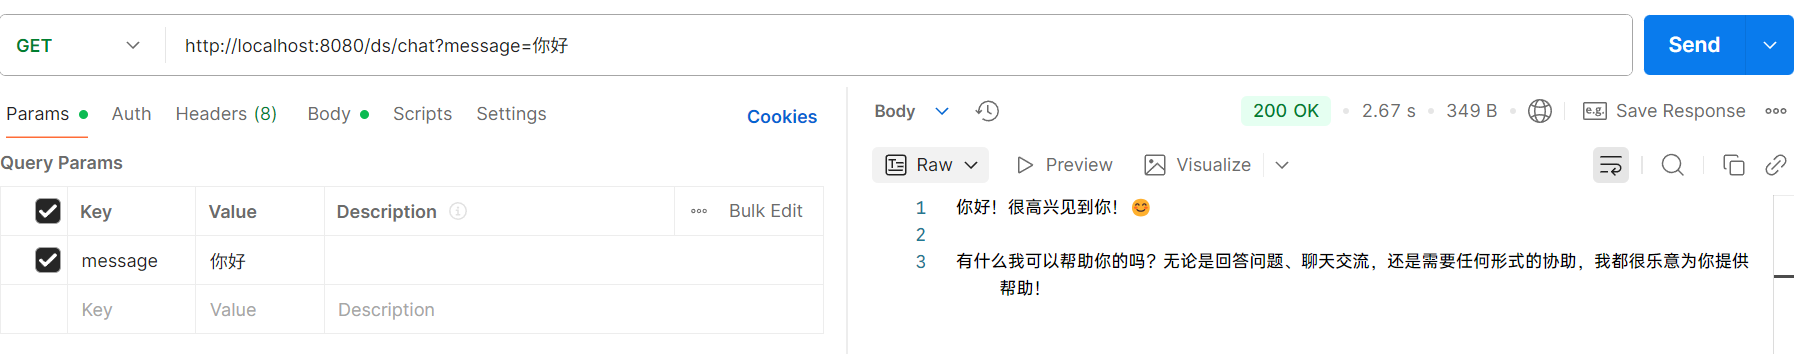
需要注意,如果是使用ChatGPT、Anthropic等外国的模型,并且是通过代理的方式连接的服务,则需要在应用程序中手动配置一下代理,默认情况下Spring AI应用不会走本地代理。在启动类中添加下面的代码:
| Java | |
|---|---|
1 2 3 4 | |
Spring AI聊天模型
Spring AI的聊天模型,通过标准化的接口设计,使开发人员可以将AI模型的聊天功能集成到应用程序中。它利用预先训练的语言模型,例如GPT(Generative Pre-trained Transformer),以自然语言生成类似人类的响应
API的工作原理通常是向AI模型发送提示或部分对话,然后AI模型根据其训练数据和对自然语言模式的理解生成响应。然后,把响应将返回给应用程序,应用程序可以将其呈现给用户或将其用于进一步处理
在Spring AI框架中,ChatModel和ChatClient是构建对话式AI应用的两个核心接口。上面使用了ChatModel完成了与AI模型的交互,下面对这两个接口分别进行介绍
ChatClient
ChatClient是Spring AI框架中封装复杂交互流程的高阶API接口(ChatClient基于ChatModel进行的封装),旨在简化开发者与大语言模型(如GPT、通义千问等)的集成过程。ChatClient提供了与AI模型通信的Fluent API(支持链式调用),它支持同步和异步编程模型,将与LLM及其他组件交互的复杂性进行封装,给用户提供开箱即用的服务
基本使用
要想使用ChatClient首先需要拿到ChatClient对象,可以通过下面的方式进行:
| Java | |
|---|---|
1 2 3 4 5 6 | |
接着使用ChatClient:
| Java | |
|---|---|
1 2 3 4 5 6 7 | |
角色预设
角色预设是给模型提前定义身份、语气和行为边界的一种方式,你可以把它理解为在对话开始前先给模型一份“长期有效的工作说明”
在Spring AI的ChatClient.Builder中,defaultSystem()方法用于设置AI模型的默认系统消息(System Message),它会作为对话的基础角色设定或初始指令。通过ChatClient.Builder链式调用设置后,该方法定义的文本会作为系统消息注入到每次对话的上下文中,用于引导AI的回复风格或身份设定,它会在每次对话中自动生效,从而让模型保持统一的人设、稳定的回复风格,并减少用户输入对整体行为的干扰
例如下面的代码:
| Java | |
|---|---|
1 2 3 4 5 6 | |
进行角色预设之后,AI的回答就会更加个性化,例如下面的对比:
| Text Only | |
|---|---|
1 2 3 4 5 6 7 | |
| Text Only | |
|---|---|
1 | |
除了使用ChatClientBuilder的defaultSystem()方法设置系统提示词以外,还可以使用ChatClient的system()方法设置系统提示词:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 | |
结构化输出
Spring AI 的结构化输出,指的是把大模型原本返回的字符串结果,转换成应用更容易处理的结构化数据,比如JSON、XML或Java POJO。Spring AI 会在模型调用前补充格式约束,在模型返回后再把文本解析并映射成目标类型,这样可以减少手工解析成本,也更方便在业务代码里直接使用。不过它本质上仍然是 best effort,模型不一定每次都严格按格式返回,所以通常还需要配合校验。对于支持原生结构化输出的模型,Spring AI也可以直接利用模型侧的能力来提高结果可靠性
例如有一个实体类Movie:
| Java | |
|---|---|
1 2 3 4 5 6 7 | |
如果想让AI返回实体类结果,可以使用entity(Class<T> type)方法,例如下面的代码:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 | |
结果如下:
| Text Only | |
|---|---|
1 2 | |
流式结果返回
用户和模型进行交互时,由于大模型一次输出内容较多,等待全部内容生成完毕会导致用户等待时间过长,这对用户的体验非常不友好。可以采用流式输出的方式(例如ChatGPT和DeepSeek逐字显示回答)
流式输出是一种结果返回方式,模型在生成内容的过程中会持续向调用方推送片段,借用流式编程是实现这种能力的编程模型,Spring AI通过Reactor的Flux来承载这种异步数据流
使用流式返回需要将call()方法修改为stream()方法,并将返回值修改为Flux<T>,例如:
| Java | |
|---|---|
1 2 3 4 5 6 7 | |
如果在浏览器中访问这个方法,就能看到结果是逐字显示内容,但是发现结果全是乱码。本质是因为流式输出并不是一次性将结果给浏览器,而是分片给,浏览器不知道结果的编码格式,自然也就不知道如何解码结果。在响应头中可以看到Content-Type只有text/html:
| Text Only | |
|---|---|
1 2 3 4 5 6 | |
为了解决这个问题,可以在@GetMapping中指定返回结果的格式和编码(例如text/html;charset=utf-8):
| Java | |
|---|---|
1 2 3 4 5 6 7 | |
再次运行程序即可看到输出结果显示正常,响应头也有对应的编码:
| Text Only | |
|---|---|
1 2 3 4 5 6 | |
Advisor与基础使用
Spring AI中的Advisors是介于用户请求与AI模型之间的中间件组件,它的核心功能就是对请求进行拦截过滤和增强,帮助我们在API调用前后解决各种问题,例如调用前参数如何构建,调用后结果如何处理
Spring AI中的Advisors是基于AOP思想实现的,在具体实现上进行了领域适配。其设计核心借鉴了Spring AOP的拦截机制,各个Advisor以链式结构运行,序列中的每个Advisor都有机会对传入的请求和传出的响应进行处理。这种链式处理机制确保了每个Advisor可以在请求和响应流中添加自定义的逻辑,从而实现更灵活和可定制的功能
应用场景:
- 敏感词过滤
- 重建聊天历史
- 对话上下文管理
下面以Spring AI内置的日志Advisor为例(SimpleLoggerAdvisor)。其使用非常简单,开发人员只需把它添加到Advisor链中,即可自动记录所有经过该Advisor的聊天请求和响应,并且开发人员可以对其进行配置,如日志级别和日志格式。例如使用ChatClientBuilder的defaultAdvisors(Advisors... advisors)方法设置:
| Java | |
|---|---|
1 2 3 4 5 6 7 | |
除此之外,还可以使用ChatClient的advisors(Advisors... advisors)方法设置,与系统提示词类似,此处不再演示。但是需要注意的是,如果同时使用了两种方式设置Advisor,则以ChatClient的为准,相当于“覆盖”默认
使用下面的配置调整Advisor日志的等级:
| XML | |
|---|---|
1 2 3 | |
接着在控制台能看到类似下面的结果:
| Text Only | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 | |
对话记忆与会话历史
Spring AI对对话记忆和会话历史的支持,核心是把大模型的“无状态”能力补成“可持续上下文”。它提供了ChatMemory抽象来保存和读取会话中的消息,底层由ChatMemoryRepository负责消息存储,ChatMemory则决定保留哪些消息、何时清理这些消息。对于ChatMemory接口定义如下:
| Java | |
|---|---|
1 2 3 4 5 6 | |
在对话系统(尤其是大语言模型应用)中,SystemMessage、UserMessage和AssistantMessage是三种核心消息类型,用于构建上下文感知的对话框架:
| 消息类型 | 说明 | 角色 |
|---|---|---|
SystemMessage | 系统消息,通常由系统设定或初始化时提供,用于设定对话的背景、角色、行为准则等。它不是用户或助手发出的,是系统层面的指令或上下文信息。例如,在对话开始前,系统消息可以设定助手的角色:"你是一个乐于助人的助手,用中文回答问题。" | 定义模型身份、行为规范、知识边界 |
UserMessage | 用户消息,即由用户输入的内容。在对话中,用户的问题或语句都属于此类。 | 驱动单次任务执行(如提问、创作指令) |
AssistantMessage | 助手消息,即由助手(通常是AI模型)生成并返回给用户的响应。 | 持续影响所有交互(如角色设定、安全过滤) |
例如,一个对话如下:
SystemMessage:"你是一个翻译助手,将用户的中文翻译成英文。"UserMessage:"你好,今天天气真好。"AssistantMessage:"Hello, the weather is really nice today."
当模型生成回复时,它会看到整个对话历史(包括系统消息、之前的用户消息和助手消息),从而生成连贯且符合上下文的回复
在技术实现上,不同框架或库可能会采用不同的命名,但核心思想一致。例如,在OpenAI的API中,消息以角色(role)字段区分,包括"system"、"user"、"assistant"
在多轮对话中,AssistantMessage与UserMessage交替排列形成时序链,使模型能通过注意力机制理解当前问题的前置语境(短期记忆)
在ChatClient场景下,Spring AI提供了多个内置Advisor来自动管理对话上下文,例如MessageChatMemoryAdvisor、PromptChatMemoryAdvisor和VectorStoreChatMemoryAdvisor。这些Advisor会在调用模型前,根据conversationId取出对应会话的历史消息,并把它们注入到当前Prompt中,这样开发者就不需要手动拼接历史对话内容。如果要保存完整聊天记录,通常要结合其他持久化方案来单独存储,例如基于数据库实现,主要是ChatMemoryRepository这一层的消息持久化存储,也就是把对话中的消息写入数据库、再按会话读出来
在JDBC场景下,具体实现是JdbcChatMemoryRepository。Spring AI还通过JdbcChatMemoryRepositoryDialect适配不同数据库,比如MySQL、PostgreSQL、SQL Server等
下面以实际案例为例,基于SpringBoot + MySQL + MyBatis-Plus实现对话历史和会话功能
对话记忆和会话历史持久层
首先创建基于MyBatis-Plus实现的对话历史持久层,先定义表实体类:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 | |
接着,创建该实体类的Mapper:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 | |
接着实现ChatMemoryRepository中需要实现的方法以确保Spring AI可以调用对应的方法保存、获取和删除对话历史:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 | |
AI配置对话记忆Advisor
使用自定义实现的MyBatisPlusChatMemoryRepository配置到MessageChatMemoryAdvisor中:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | |
实现Controller和Service
首先创建需要使用到的视图类:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 | |
| Java | |
|---|---|
1 2 3 4 5 6 7 8 | |
接着创建Controller和Service:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 | |
定义接口:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 | |
定义实现类:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 | |
敏感词处理
在Spring AI中,如果只是想对用户输入做一层简单的敏感词拦截,可以直接使用内置的SafeGuardAdvisor。根据Spring AI官方Javadoc的说明,它的作用是在真正调用模型提供商之前,先检查用户输入中是否包含指定的敏感词;一旦命中,就直接拦截本次调用并返回失败响应,不再把请求发送给大模型
从定位上看,SafeGuardAdvisor属于本地规则拦截,适合处理一些确定性的关键词场景,例如:
- 禁止用户输入某些违规词
- 拦截明显不符合业务要求的问题
- 在真正访问模型前先做一层轻量保护
它的使用方式非常直接,通常通过Builder进行配置:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | |
其中几个核心配置项如下:
sensitiveWords(List<String>):配置需要拦截的敏感词列表failureResponse(String):命中敏感词后直接返回给前端或调用方的固定文案order(int):设置Advisor在责任链中的执行顺序,值越小越先执行
如果只是想在某一次请求里临时启用敏感词拦截,也可以不放到全局配置中,而是在调用时动态添加:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 | |
例如当用户输入:
| Text Only | |
|---|---|
1 | |
如果命中了诈骗这个敏感词,那么SafeGuardAdvisor会直接终止本次调用,并返回你设置的失败文案,而不会继续请求DeepSeek、OpenAI或其他模型服务
如果项目里同时配置了多个Advisor,建议把SafeGuardAdvisor放在比较靠前的位置,让它先完成输入校验,再决定是否继续执行日志记录、对话记忆、RAG检索等后续逻辑。例如:
| Java | |
|---|---|
1 2 3 4 5 6 7 | |
这样做的好处是,一旦请求本身就不允许通过,就不会继续走后面的Advisor链,逻辑上更清晰,也能减少不必要的上下文拼装和模型调用
不过需要注意,SafeGuardAdvisor本质上是基于你手工配置的敏感词列表进行拦截,它更像“关键词闸门”,并不是语义级的内容安全审核。如果你的业务需要更细粒度的违规识别,例如仇恨、骚扰、自残、成人内容等分类审核,那么更适合结合Spring AI官方提供的Moderation能力,例如OpenAI Moderation Model来完成内容审核
简单理解两者的区别:
| 方式 | 核心特点 | 适合场景 |
|---|---|---|
SafeGuardAdvisor | 本地关键词拦截,配置简单,执行成本低 | 业务规则明确、敏感词固定 |
ModerationModel | 由模型服务做内容审核,识别能力更强 | 需要更完整的内容安全分类能力 |
所以在实际项目中,可以把SafeGuardAdvisor当作第一层快速拦截,把Moderation当作更专业的第二层审核机制。前者解决“已知规则”,后者解决“复杂内容识别”
ChatModel
基本介绍
ChatModel是Spring AI构建对话应用的核心接口,它抽象了应用与模型交互的过程,包括使用Prompt作为输入,使用ChatResponse作为输出等。ChatModel的工作原理是接收Prompt或部分对话作为输入,将输入发送给后端大模型,模型根据其训练数据和对自然语言的理解生成对话响应,应用程序可以将响应呈现给用户或用于进一步处理
String call(String message)方法就是对message进行了封装,简化了ChatModel的初始化使用,避免了更复杂的Prompt输入和ChatResponse输出,本质上调用的依然是ChatResponse call(Prompt prompt)。在源码中,ChatModel定义基本如下:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 | |
Prompt对象构造支持传递Message对象及其子类,常见的Message子类如下:
| 类型 | 描述 |
|---|---|
SystemMessage | 系统消息,用来设定模型的角色、行为规则、回复风格和上下文边界 |
UserMessage | 用户消息,表示用户输入的问题、指令或普通对话内容 |
AssistantMessage | 助手消息,表示模型历史回复;在多轮对话中用于保留模型的上下文 |
ToolResponseMessage | 工具响应消息,表示工具或函数调用后的返回结果,用于把外部执行结果回传给模型 |
根据上述逻辑,也可以自行调用call(Prompt prompt)方法:
| Java | |
|---|---|
1 2 3 4 5 | |
同样,ChatModel也支持角色预设,本质就是构造不同的消息类型:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 | |
对于流式输出,可以参考下面的例子:
| Java | |
|---|---|
1 2 3 4 5 | |
ChatClient和ChatModel对比
ChatClient和ChatModel是Spring AI框架提供的与大语言模型(LLM)交互的两个核心接口。但二者设计理念和适用场景不太一样
ChatModel是Spring AI框架中的底层接口,提供基础的call和stream方法,直接与具体的大语言模型(如通义千问、OpenAI)交互,在使用上相对更加灵活。开发人员需手动处理提示词组装、参数配置和响应解析等细节ChatClient对ChatModel进行了封装,相比ChatModel原始类API,ChatClient屏蔽了与AI模型的交互的复杂性,它自动集成提示词管理、响应格式化、结构化输出映射等功能,提高了开发效率
| 维度 | ChatClient | ChatModel |
|---|---|---|
| 交互方式 | 链式API,自动封装请求与响应 | 手动构建Prompt,解析响应 |
| 结构化输出 | 支持.entity(Class)自动映射POJO | 手动解析文本 |
| 扩展能力 | 内置Advisor机制,提供更高级的功能,如提供上下文记忆、RAG等功能 | 依赖外部组件 |
| 适合场景 | 适合快速构建AI服务,如带记忆的客服系统 | 适合需要精细控制模型参数的场景,如模型实验、参数调优等定制需求 |
本地大模型部署
随着大语言模型(LLM)的广泛应用,如何高效部署和推理模型成为开发者关注的核心问题,常见的部署方案有云服务部署和本地部署
云服务部署,在云服务平台的机器上部署大模型,本地部署则是指在本地机器上进行部署大模型
部署方案对比
| 维度 | 云部署 | 本地部署 |
|---|---|---|
| 费用 | 前期成本低,长期成本高 | 前期成本高,长期成本低 |
| 维护 | 简单 | 复杂 |
| 弹性扩展 | 简单 | 复杂,定制性强 |
| 网络 | 依赖网络,全球访问 | 不依赖网络 |
| 数据安全 | 隐私性差 | 数据安全 |
常见云服务平台介绍
如果不需要对模型进行训练、微调,仅仅是想使用预调好的大模型进行应用开发,很多模型提供商也提供了开放API,如上面讲的DeepSeek和ChatGPT,直接调用他们的API即可。
国内很多知名的云服务平台提供了大模型的私有部署功能(提供预置模型库,不同厂商预置的模型库也不同),可以按任务需求选择基础版本或者微调版本,甚至还提供了这些模型的API开放平台,无需部署就可以访问。
| 公司 | 云平台 | 地址 |
|---|---|---|
| 阿里巴巴 | 阿里百炼 | https://bailian.console.aliyun.com/ |
| 百度 | 千帆平台 | https://cloud.baidu.com/product-s/qianfan_home |
| 腾讯 | 腾讯TI平台 | https://cloud.tencent.com/product/ti |
| 华为 | 华为昇腾云 | https://www.huaweicloud.com/product/ecs/ascend.html |
本地部署
大模型本地部署,就是把大模型部署到我们本地的机器上。由于大模型的参数很多,使用普通方法部署大模型很不友好,所以诞生了一些本地部署的框架/工具来帮助我们部署大模型。
常见的本地部署框架/工具有:
- Transformers
- vLLM
- llama.cpp
- Ollama
- LM Studio
- ......
这些工具中,操作比较简单的一种方案就是使用Ollama
Ollama是一款专为本地部署和运行大型语言模型(LLM)设计的开源工具,旨在简化大型语言模型(LLM)的安装、运行和管理。它支持多种开源模型(如qwen、deepseek、LLaMA),并提供简单的API接口,方便开发者调用,适合开发者和企业快速搭建私有化AI服务
Ollama官网:https://ollama.ai
安装完成后,Ollama默认会启动。
访问http://127.0.0.1:11434,或者使用cmd访问ollama --version
Ollama可以管理和部署模型,使用之前,需要先拉取模型。拉取之前可以修改模型存储路径
模型默认安装在C盘个人目录下C:\Users\XXX\.ollama,可以修改ollama的模型存储路径,使得每次下载的模型都在指定的目录下
有以下两种方式:
-
配置系统环境变量
Text Only 1 2
变量名: OLLAMA_MODELS 变量值: ${自定义路径} -
通过Ollama界面来进行设置
设置完成后,重启Ollama即可。查找模型:https://ollama.com/search
以DeepSeek-R1为例,DeepSeek-R1是一系列开放推理模型,DeepSeek-R1有不同的版本,我们需要根据机器的配置及需求来选择相应的版本。
Info
分为1.5b、7b、8b等,"b"是"Billion"(十亿)的缩写,代表模型的参数量级。671b表示"满血"版本,其他版本称为"蒸馏"版本。
参数越多 → 模型"知识量"越大 → 处理复杂任务的能力越强,硬件需求也越高
根据需求及电脑配置,选择合适的模型版本,以1.5b为例:
| Bash | |
|---|---|
1 | |
下载完成之后,就会出现命令行,可以通过命令行启动AI模型并进行对话:
| Bash | |
|---|---|
1 | |
Spring AI接入Ollama服务
创建模块spring-ollama-demo,引入Ollama依赖:
| XML | |
|---|---|
1 2 3 4 | |
编写配置文件application.yml:
| YAML | |
|---|---|
1 2 3 4 5 6 7 8 9 10 | |
简单对话的示例代码:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 | |
同样也可以实现流式响应:
| Java | |
|---|---|
1 2 3 4 | |
为了便于使用,也可以将Ollama的ChatModel封装成ChatClient:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 | |
后续即可使用ChatClient编写AI相关代码,例如:
| Java | |
|---|---|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | |